
The Fortieth Annual Conference on Neural Information Processing Systems是人工智能与机器学习领域的三大国际会议之一,为CCF A类会议。第40届NeurIPS将于2026年12月在澳大利亚悉尼举行,并在法国巴黎和美国亚特兰大设立卫星会场,录用率为25.7%。ASC实验室本次接收11篇论文,主题涉及激光雷达定位、点云配准、视觉定位、事件相机目标检测、强化学习等方向。
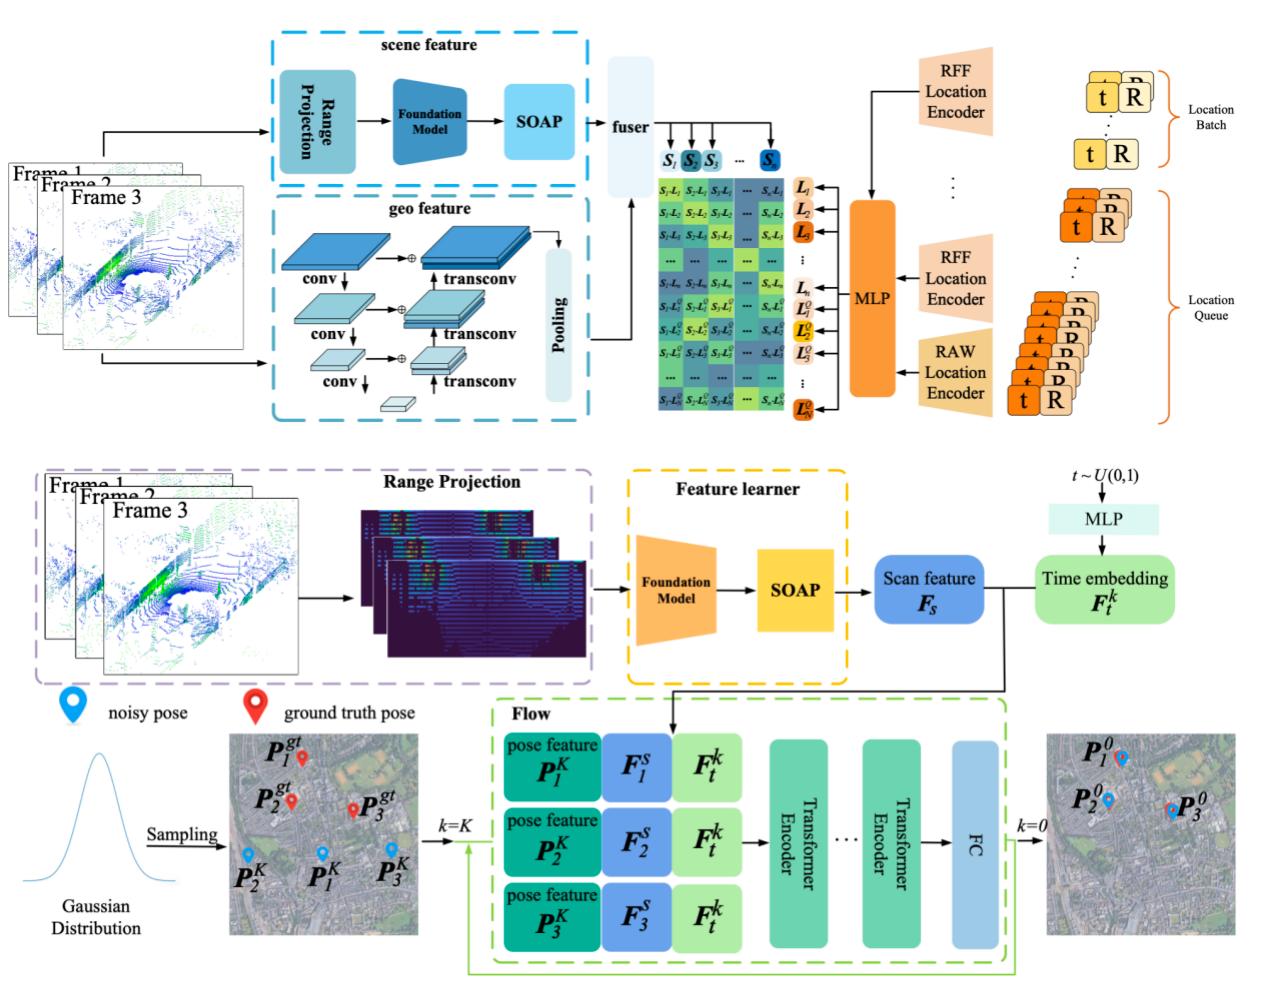
Trustworthy and Efficient Map-free LiDAR Localization via Scan-Pose Alignment and Flow Matching
简介:LiDAR重定位对自动驾驶至关重要。现有绝对位姿回归方法面临精度-效率权衡。同时,目前依赖启发式方差或多步采样的可靠性估计校准差、开销高。为此,本文将定位可靠性建模为查询点云帧与预测位姿在隐空间中的兼容性,提出可信且高效的重定位框架,包含即插即用的置信度估计器SPAR与流匹配位姿回归器VeLoc。SPAR以双流架构和姿态记忆队列学习点云-位姿对齐,仅需单次前向即可输出与定位误差负相关的置信度,可直接用于多种定位骨干实现失败检测。VeLoc利用距离图像与DINO特征,将位姿回归建模为条件流匹配,通过少步ODE积分高效恢复6-DoF位姿。在NCLT和Oxford基准上,VeLoc较基线加速约3倍并取得更优或相当精度,且SPAR在多个定位网络上实现可靠的异常拒绝。
该论文第一作者是博士生常浩泽,通讯作者是王程教授。并由刘敦强,朱明航,毕业生李文(布里斯托大学),敖晟助理教授、沈思淇长聘副教授、温程璐教授共同合作完成。
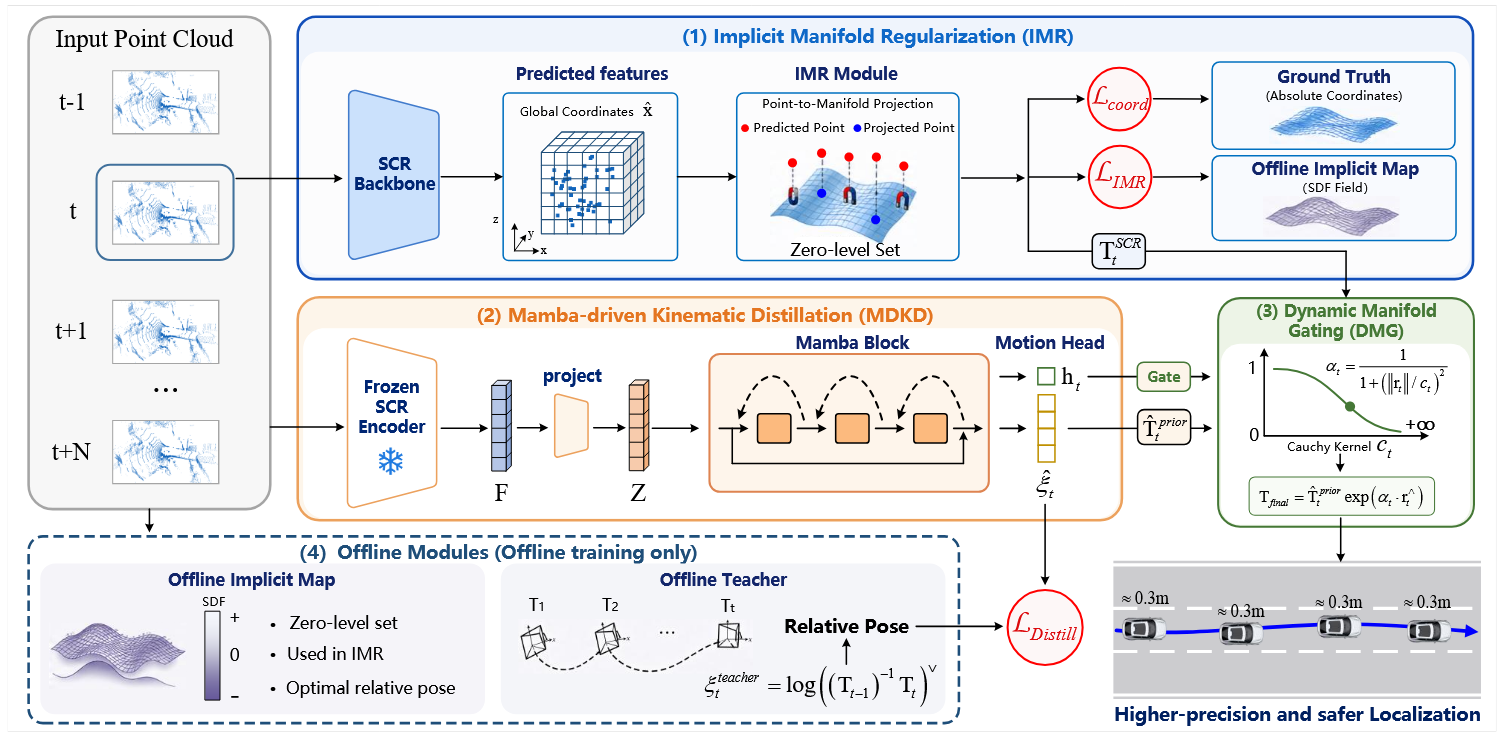
BiLi: Bridging the Last Mile in LiDAR Localization
简介:现有基于场景坐标回归的激光雷达定位方法可能产生位置跳变与高频轨迹抖动,进而引发车辆异常转向或紧急制动,难以满足车道级自动驾驶的安全需求。为此,本文提出时空协同激光雷达定位框架 BiLi。空间上,设计隐式流形正则化(IMR),利用神经隐式场将预测坐标约束至连续物理表面;时间上,通过Mamba驱动的运动学蒸馏(MDKD)学习连续车辆运动先验,并结合动态流形门控(DMG)自适应融合绝对定位与运动状态,有效抑制非物理位置跳变。本文进一步引入相对位姿误差与平均轨迹抖动率作为定位安全性指标,从时间连续性和高频位置跳变角度衡量自动驾驶定位的稳定性与安全性。
该论文第一作者是博士生朱明航、硕士生兰骏川,通讯作者是王程教授。并由王芝婧、常浩泽、毕业生李文(布里斯托大学)、敖晟助理教授共同合作完成。
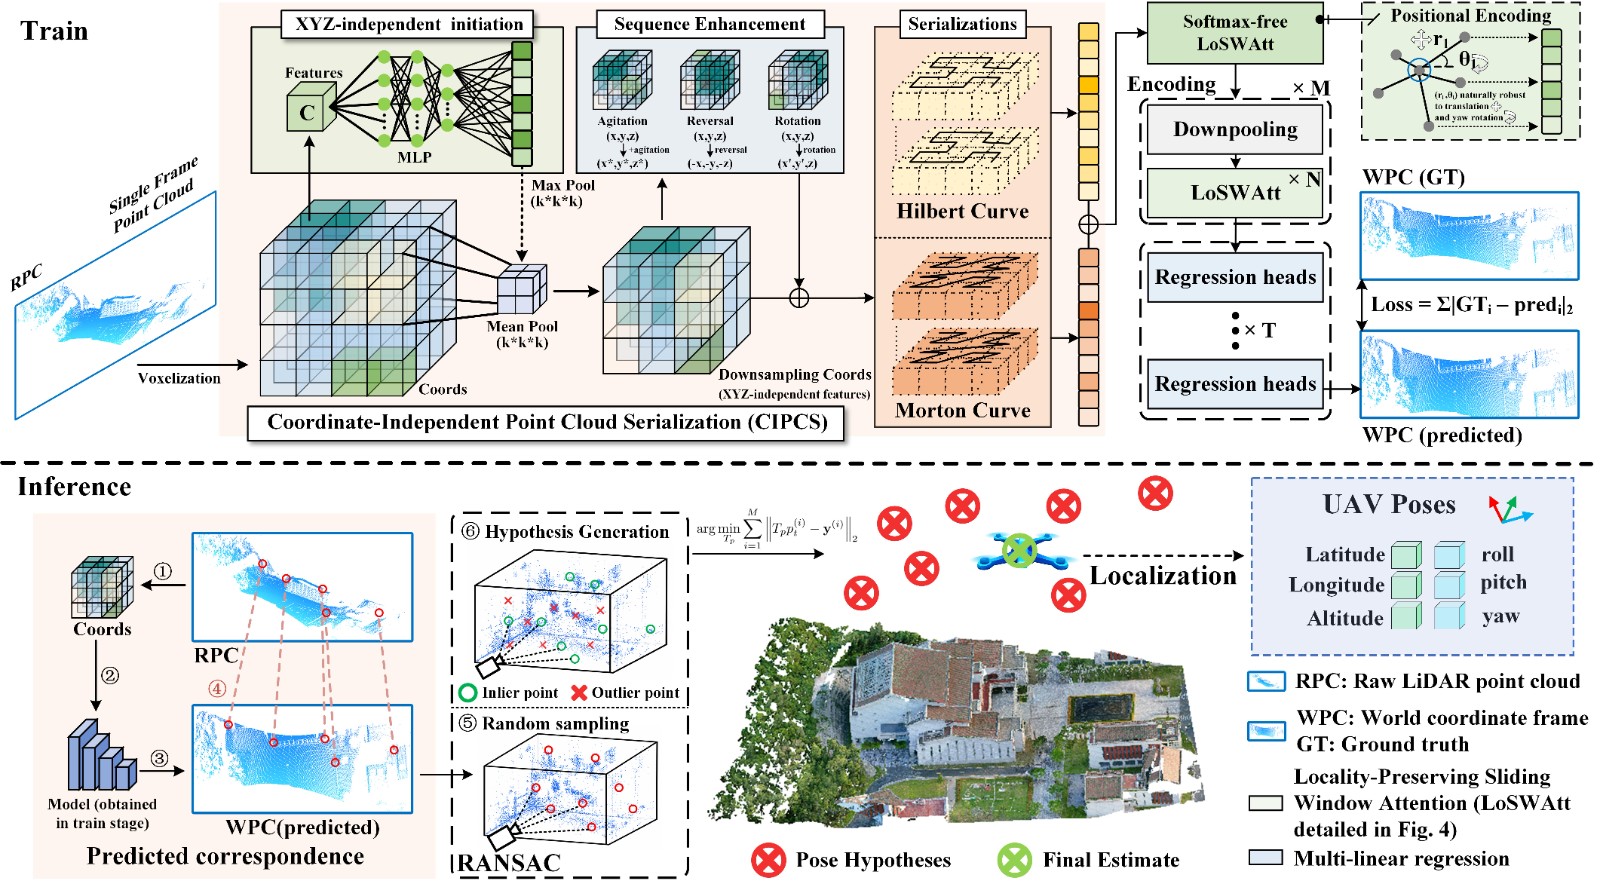
SOAR: Regression-based LiDAR Relocalization for UAVs
简介:激光雷达重定位是GNSS拒止环境下实现高精度定位的有效手段。现有这类方法大多面向自动驾驶场景设计;在无人机场景中,受剧烈位姿变化和不规则飞行轨迹影响,这些算法定位精度明显下降。因此,本文提出基于回归的激光雷达无人机重定位框SOAR。该框架引入带有局部不变位置编码的滑动窗口注意力模块,提取对视角变化鲁棒的判别性几何结构特征;并设计坐标无关的特征初始化模块,消除算法对全局变换的敏感问题。针对现有无人机激光雷达数据集缺少每帧点云的精准六自由度位姿真值及多趟遍历数据的问题,本文构建首个具有丰富高度、旋转变化和多趟不规则轨迹的大规模无人机激光雷达定位数据集UAVLoc,其包含4个场景、13条飞行轨迹,为无人机定位任务提供更贴合真实情况的基准测试集。实验结果表明,SOAR取得当前SOTA的定位性能,在UAVLoc基准上将定位成功率提升了40%,平均定位误差降低了10米以上。
该论文第一作者是博士生穆恒宇、博士生吴建实、博士生郭煜新,通讯作者是敖晟助理教授。并由林贤炼工程师、胡庆拥副研究员(军事科学院)、温程璐教授、王程教授共同合作完成。
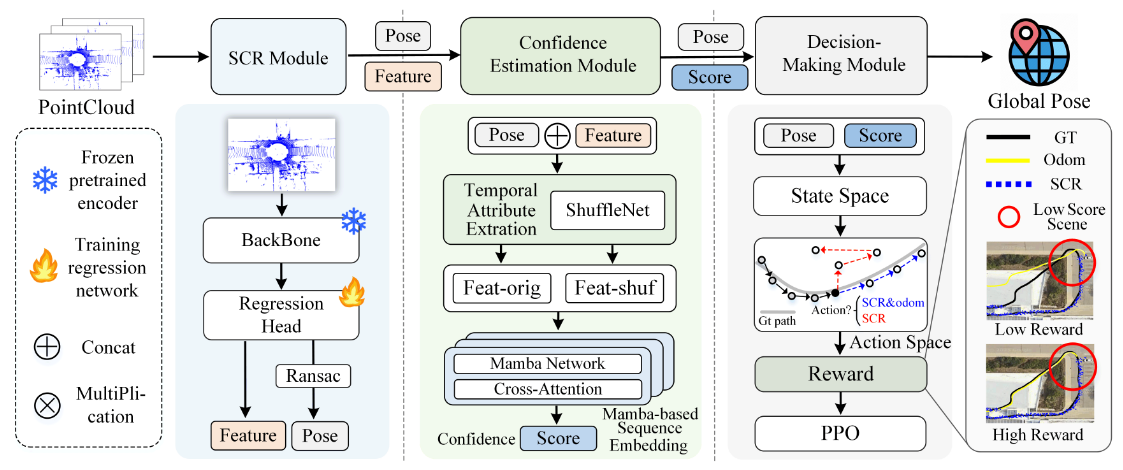
LINK: Learning to Localize from Known to Unknown Scenes
简介:现有无地图LiDAR重定位方法通常假设训练轨迹能够充分覆盖测试环境,但在真实长距离自动驾驶中,完整采集所有道路场景成本高昂,车辆不可避免地会驶入训练未覆盖的未知区域。为此,本文提出LINK,通过时序可靠性估计判断当前估计绝对位姿是否可信,并利用序列决策策略在绝对定位与相对里程计传播之间自适应切换,从而维持已知到未知场景下的连续全局定位。此外,本文构建城市级UrbanUnseen数据集,引入真实道路中的已知-未知场景切换,并结合Oxford和NCLT建立部分场景覆盖评测协议,为研究训练覆盖不完整条件下的自动驾驶定位鲁棒性与泛化能力提供更贴近实际部署的测试基准。
该论文第一作者是博士生朱明航、硕士生靳凯博,通讯作者是敖晟助理教授。并由王芝婧、石子威、毕业生李文(布里斯托大学)、王程教授共同合作完成。
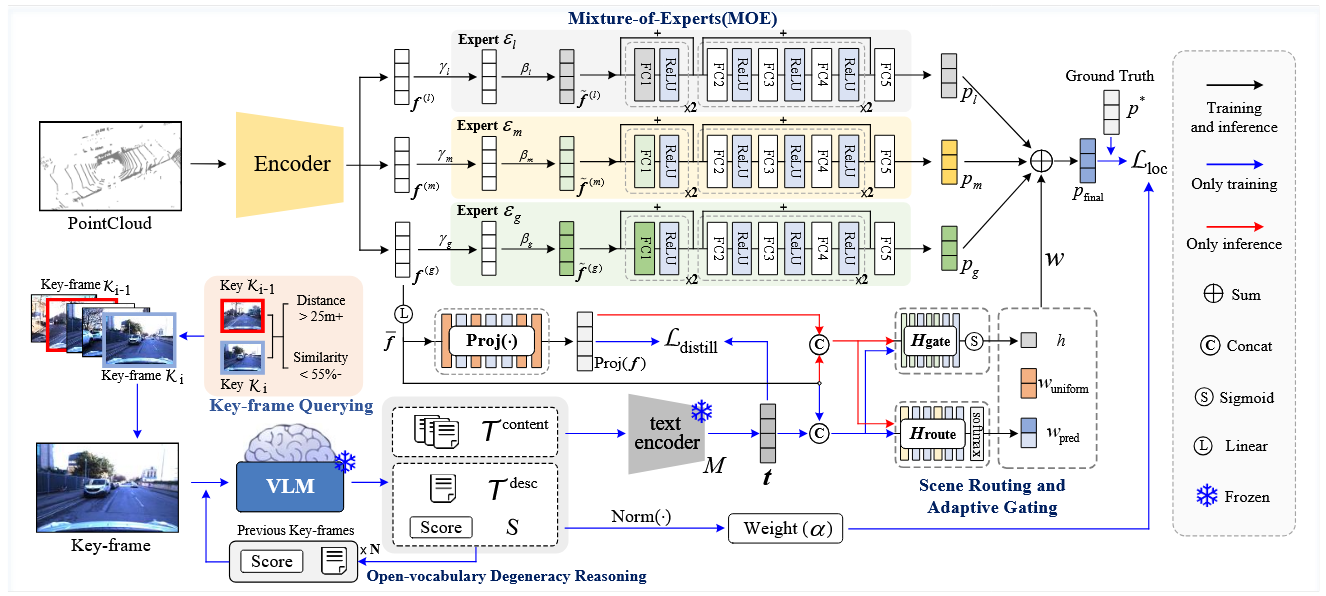
ViLo: LiDAR Localization with Vision-Language Priors
简介:激光雷达定位在自动驾驶与机器人领域具有重要作用,但现有场景坐标回归方法通常采用单一网络统一学习不同环境,在遮挡、动态物体及结构退化等复杂场景下容易产生能力干扰。为此,本文提出ViLo,首次将视觉语言模型(VLM)先验引入激光雷达场景坐标回归。具体而言,设计时序一致的关键帧查询机制,从VLM中获取开放词汇的场景退化先验;进一步构建场景自适应混合专家网络,利用语义先验动态调度不同尺度专家,实现针对不同环境的自适应特征学习;同时,通过跨模态蒸馏将VLM的场景理解能力迁移至3D骨干网络,使推理阶段仅依赖LiDAR输入,无需额外图像或VLM计算。实验表明,ViLo在Oxford RobotCar和NCLT数据集上分别将定位误差降低20%和51%。
该论文第一作者是博士生朱明航、博士生吴建实、博士生郭煜新,通讯作者是敖晟助理教授。并由毕业生李文(布里斯托大学)、王程教授共同合作完成。
SFPR: Structural Fingerprinting for LiDAR-to-OpenStreetMap Place Recognition
简介:激光雷达位置识别旨在卫星定位信号受限时,利用当前观测在地理参考地图中进行定位。OpenStreetMap为大规模低成本定位提供了轻量级地图先验,但现有方法主要依赖全局描述子匹配,容易忽略高辨识度的局部结构信息,在布局相似的场景中产生错误识别。为此,本文受人类空间导航认知机制启发,提出基于结构指纹的LiDAR-to-OSM位置识别框架SFPR。该框架利用空间稳定锚点构建结构指纹以感知注意力突出关键锚点区域,并将结构指纹提取与匹配建模为交替优化问题,通过迭代优化显式提取和匹配具有几何一致性的结构指纹,实现细粒度位置识别;同时将指纹结构一致性作为几何先验反馈至特征学习。实验表明,SFPR在KITTI、KITTI-360和PandaSet数据集上取得领先的位置识别性能,并展现出跨区域泛化能力。
该论文第一作者是博士生郑嘉焌,通讯作者是臧彧副教授。并由石子威、林晨露、汪有标、续文静、王程教授共同合作完成。
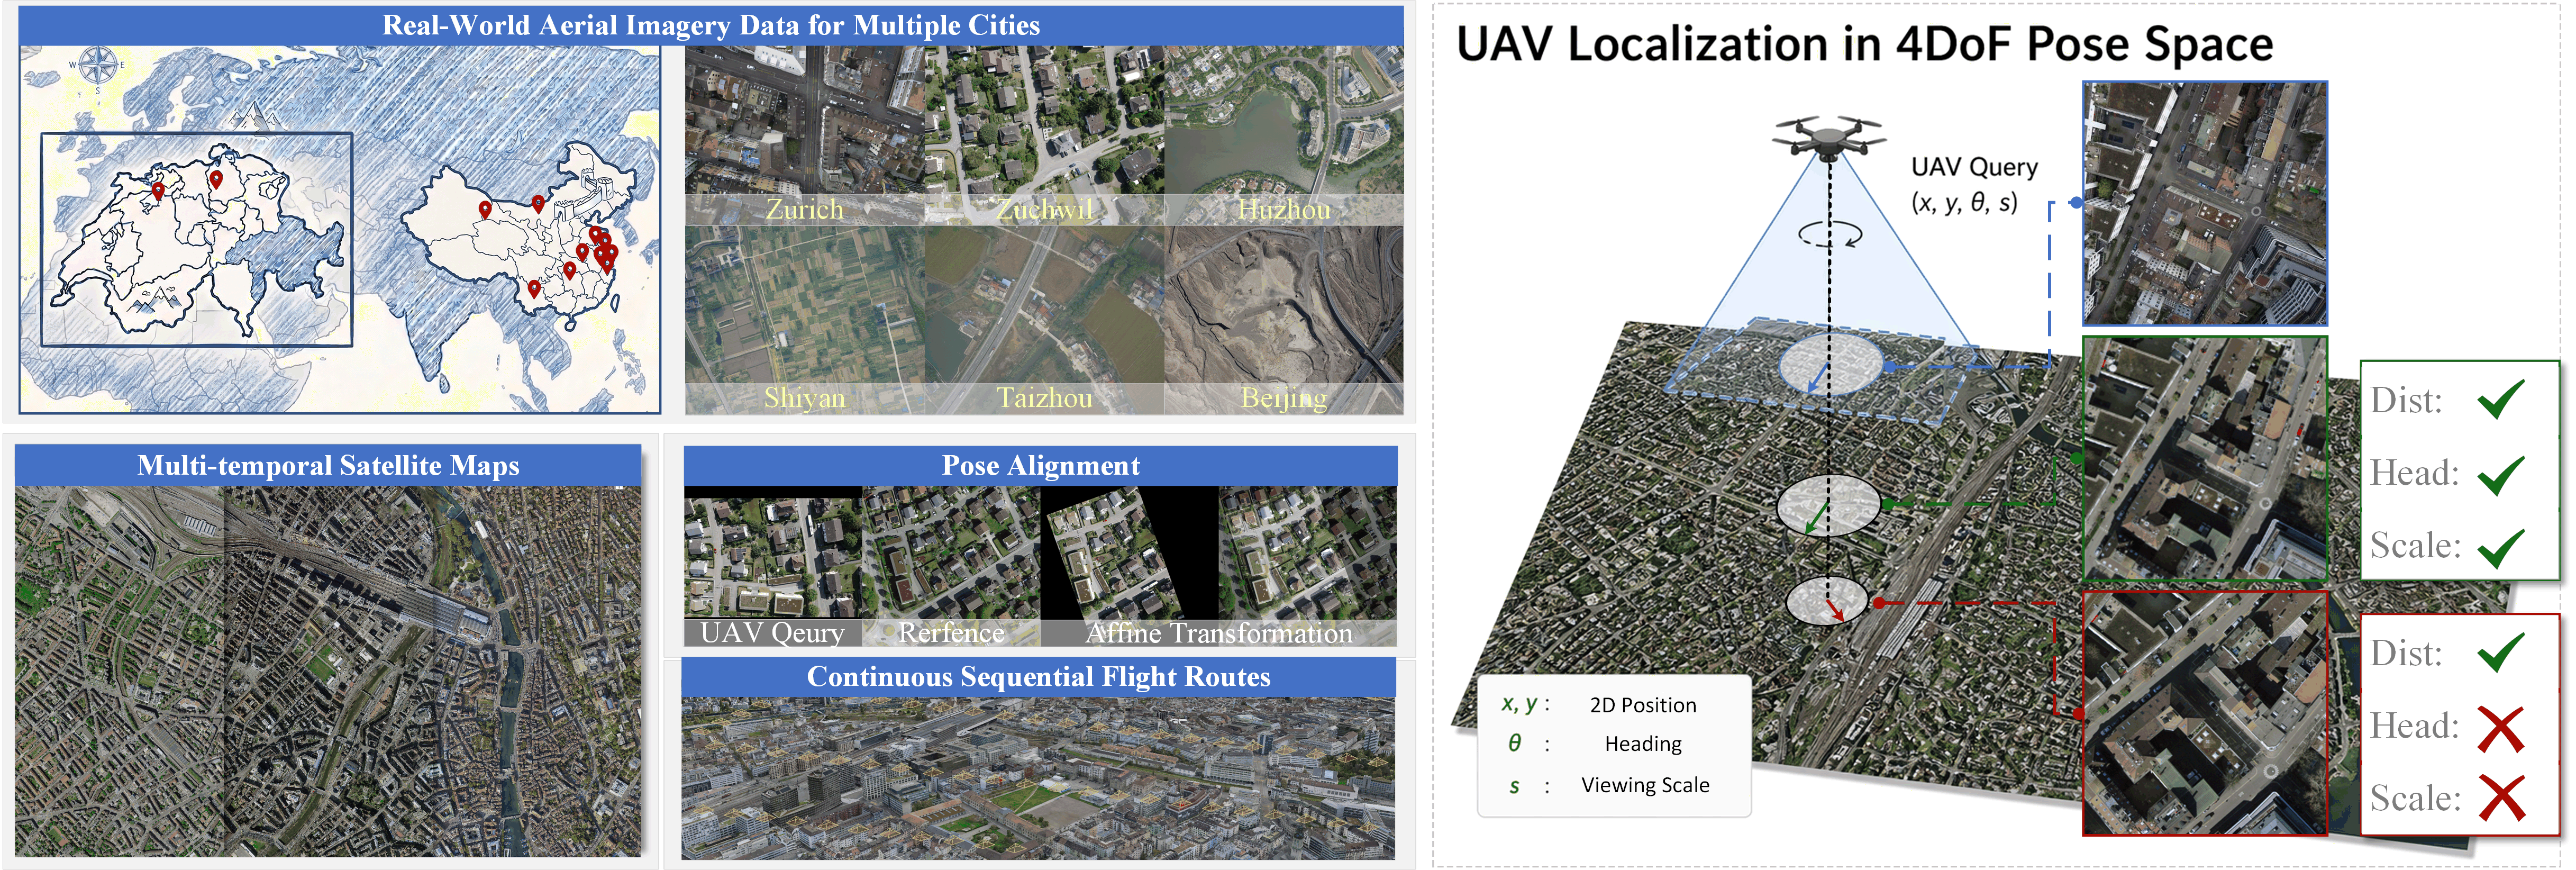
ContinuLoc: Continuous Pose Inference over Neural Fields for UAV Geo-Localization
简介:针对跨视角无人机地理定位中离散地图检索难以刻画连续位置、航向与尺度变化,且定位精度受候选采样分辨率限制的问题,本文提出连续四自由度位姿空间定位框架 ContinuLoc。该框架包含三个核心部分:1)构建多城市连续场景基准,并利用完整四自由度监督学习对位置、航向和尺度敏感的无人机观测表示;2)以位姿条件语义神经场建模地理参考场景,实现共享语义空间中任意连续位姿的适配度评估;3)设计层次化推断策略,对连续位姿空间进行全局探索并逐步收缩至高适配区域。实验表明,ContinuLoc 在距离、航向与尺度联合判定下显著优于离散检索与绝对位姿回归方法。
该论文第一作者是博士生周巍昆,通讯作者是臧彧副教授。并由林金亮、付海清、谢霖、敖晟助理教授、罗志明副教授、于尚书副教授(东北大学)、王程教授共同合作完成。
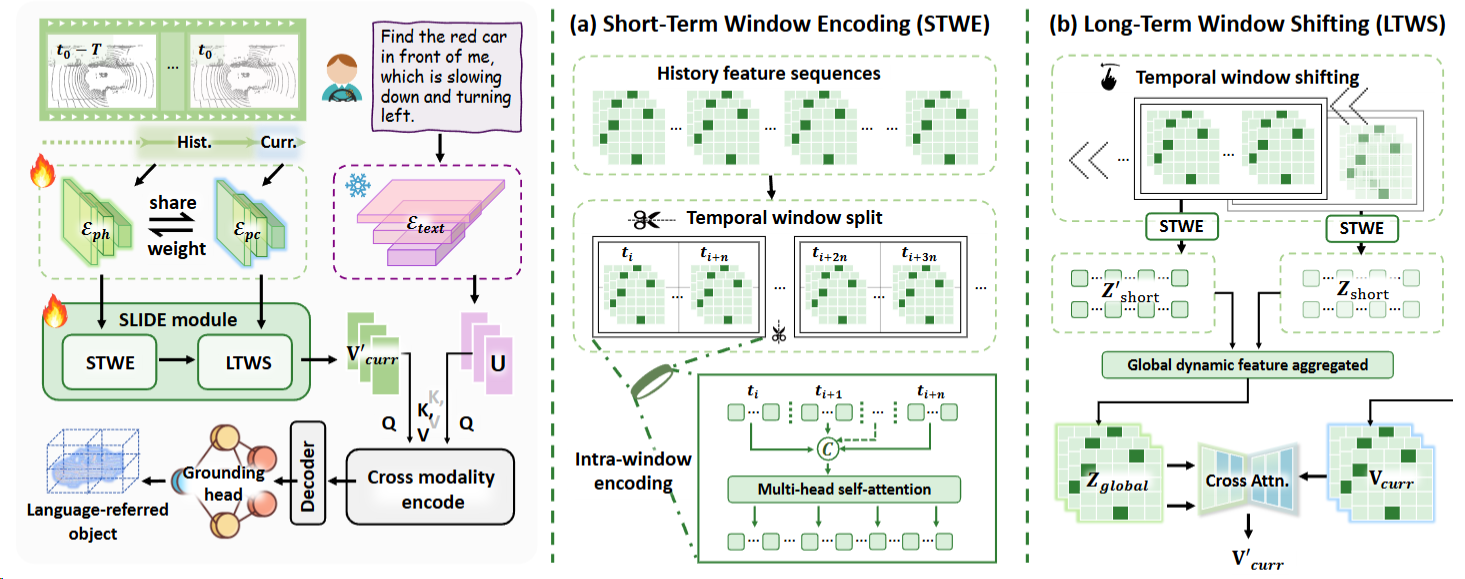
MoT3DVG: A Benchmark for Outdoor 3D Visual Grounding with Motion-Aware Descriptions and Temporal Cues
简介:三维视觉定位(3DVG)旨在根据语言描述定位三维场景中的特定目标。然而,现有研究大多聚焦于静态室内物体,难以满足自动驾驶场景中动态目标的定位需求。为此,本文引入运动语言描述以刻画目标随时间变化的动态信息,并构建了面向动态室外3DVG的大规模数据集 MoT3DVG。MoT3DVG基于nuScenes构建,包含850个场景、31,128帧以及144,568条带有时序运动信息的语言描述。此外,本文提出了DynaVG视觉定位框架,通过短长时融合动态编码模块,在语言与点云对齐前同时建模局部运动线索和全局时序上下文。在 MoT3DVG 上的大量实验证明了运动感知编码对动态室外3DVG的有效性。
该论文第一作者是博士生赵世佳,通讯作者是温程璐教授。并由郭徐晟、毕业生夏启明(香港理工大学)、黄勋、熊恪峥、刘智鸿共同合作完成。
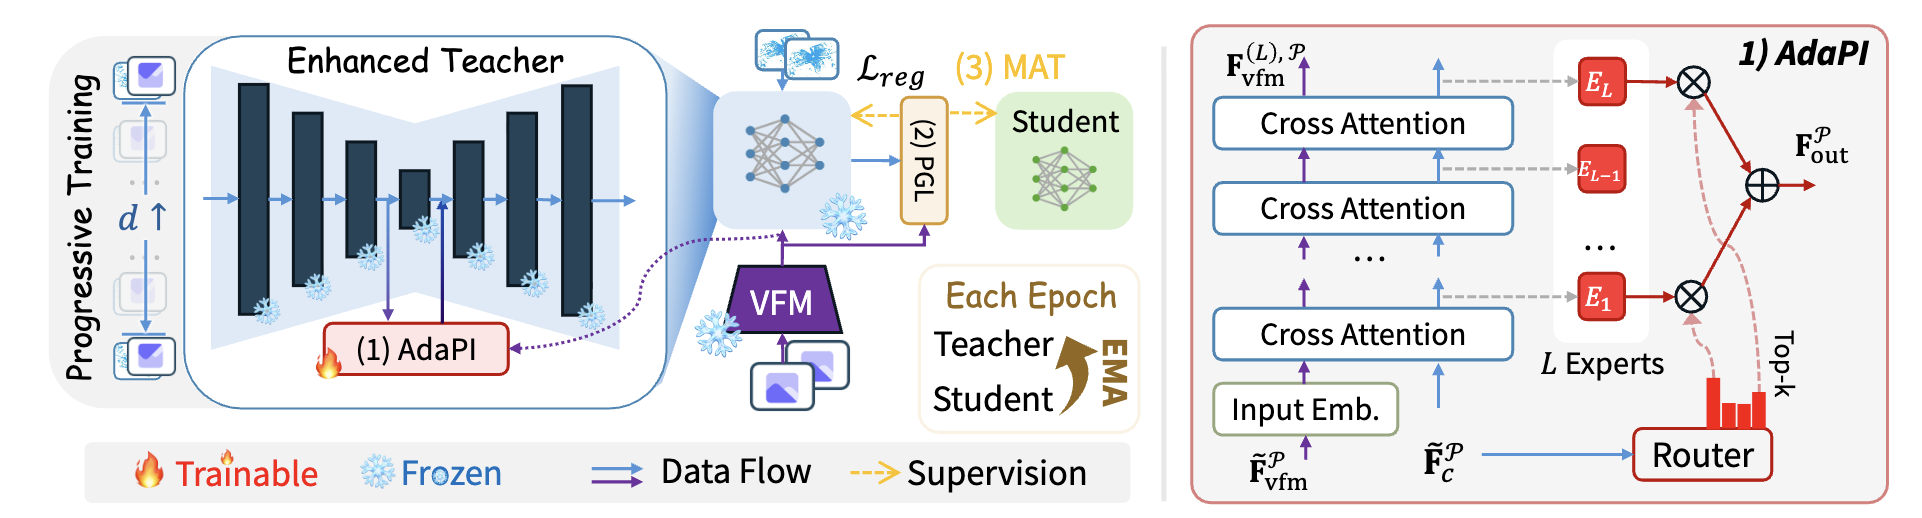
Cross-Modal Prior-Guided Training with Visual Foundation Models for Unsupervised LiDAR Point Cloud Registration
简介:点云无监督配准是重要的三维视觉任务,但伪标签噪声的累积限制了配准模型的有效无监督训练。为此,本文提出跨模态先验引导的无监督点云配准框架 PROMOTER。该框架设计自适应先验融合模块(AdaPI),从视觉基础模型中进行三维几何先验信息提取,并对教师模型动态注入与配准相关的视觉先验;该方法进一步提出感知-几何标签器(PGL),利用视觉一致性与几何一致性共同生成高质量伪标签;同时设计可匹配性锚定训练(MAT),最终将增强的教师模型中的匹配关系稳定迁移至学生模型。KITTI和nuScenes上的实验表明,PROMOTER取得了领先的无监督配准性能,并能够良好地扩展至更强的视觉基础模型,有效提升配准性能。此外,视觉基础模型仅在训练阶段使用,推理阶段无需额外图像输入或模型参数,在提升性能的同时保持了原有点云配准模型的部署效率。
该论文第一作者是博士生熊恪峥、硕士生徐诗韵,通讯作者是温程璐教授。并由敖晟助理教授、沈思淇长聘副教授、王程教授共同合作完成。
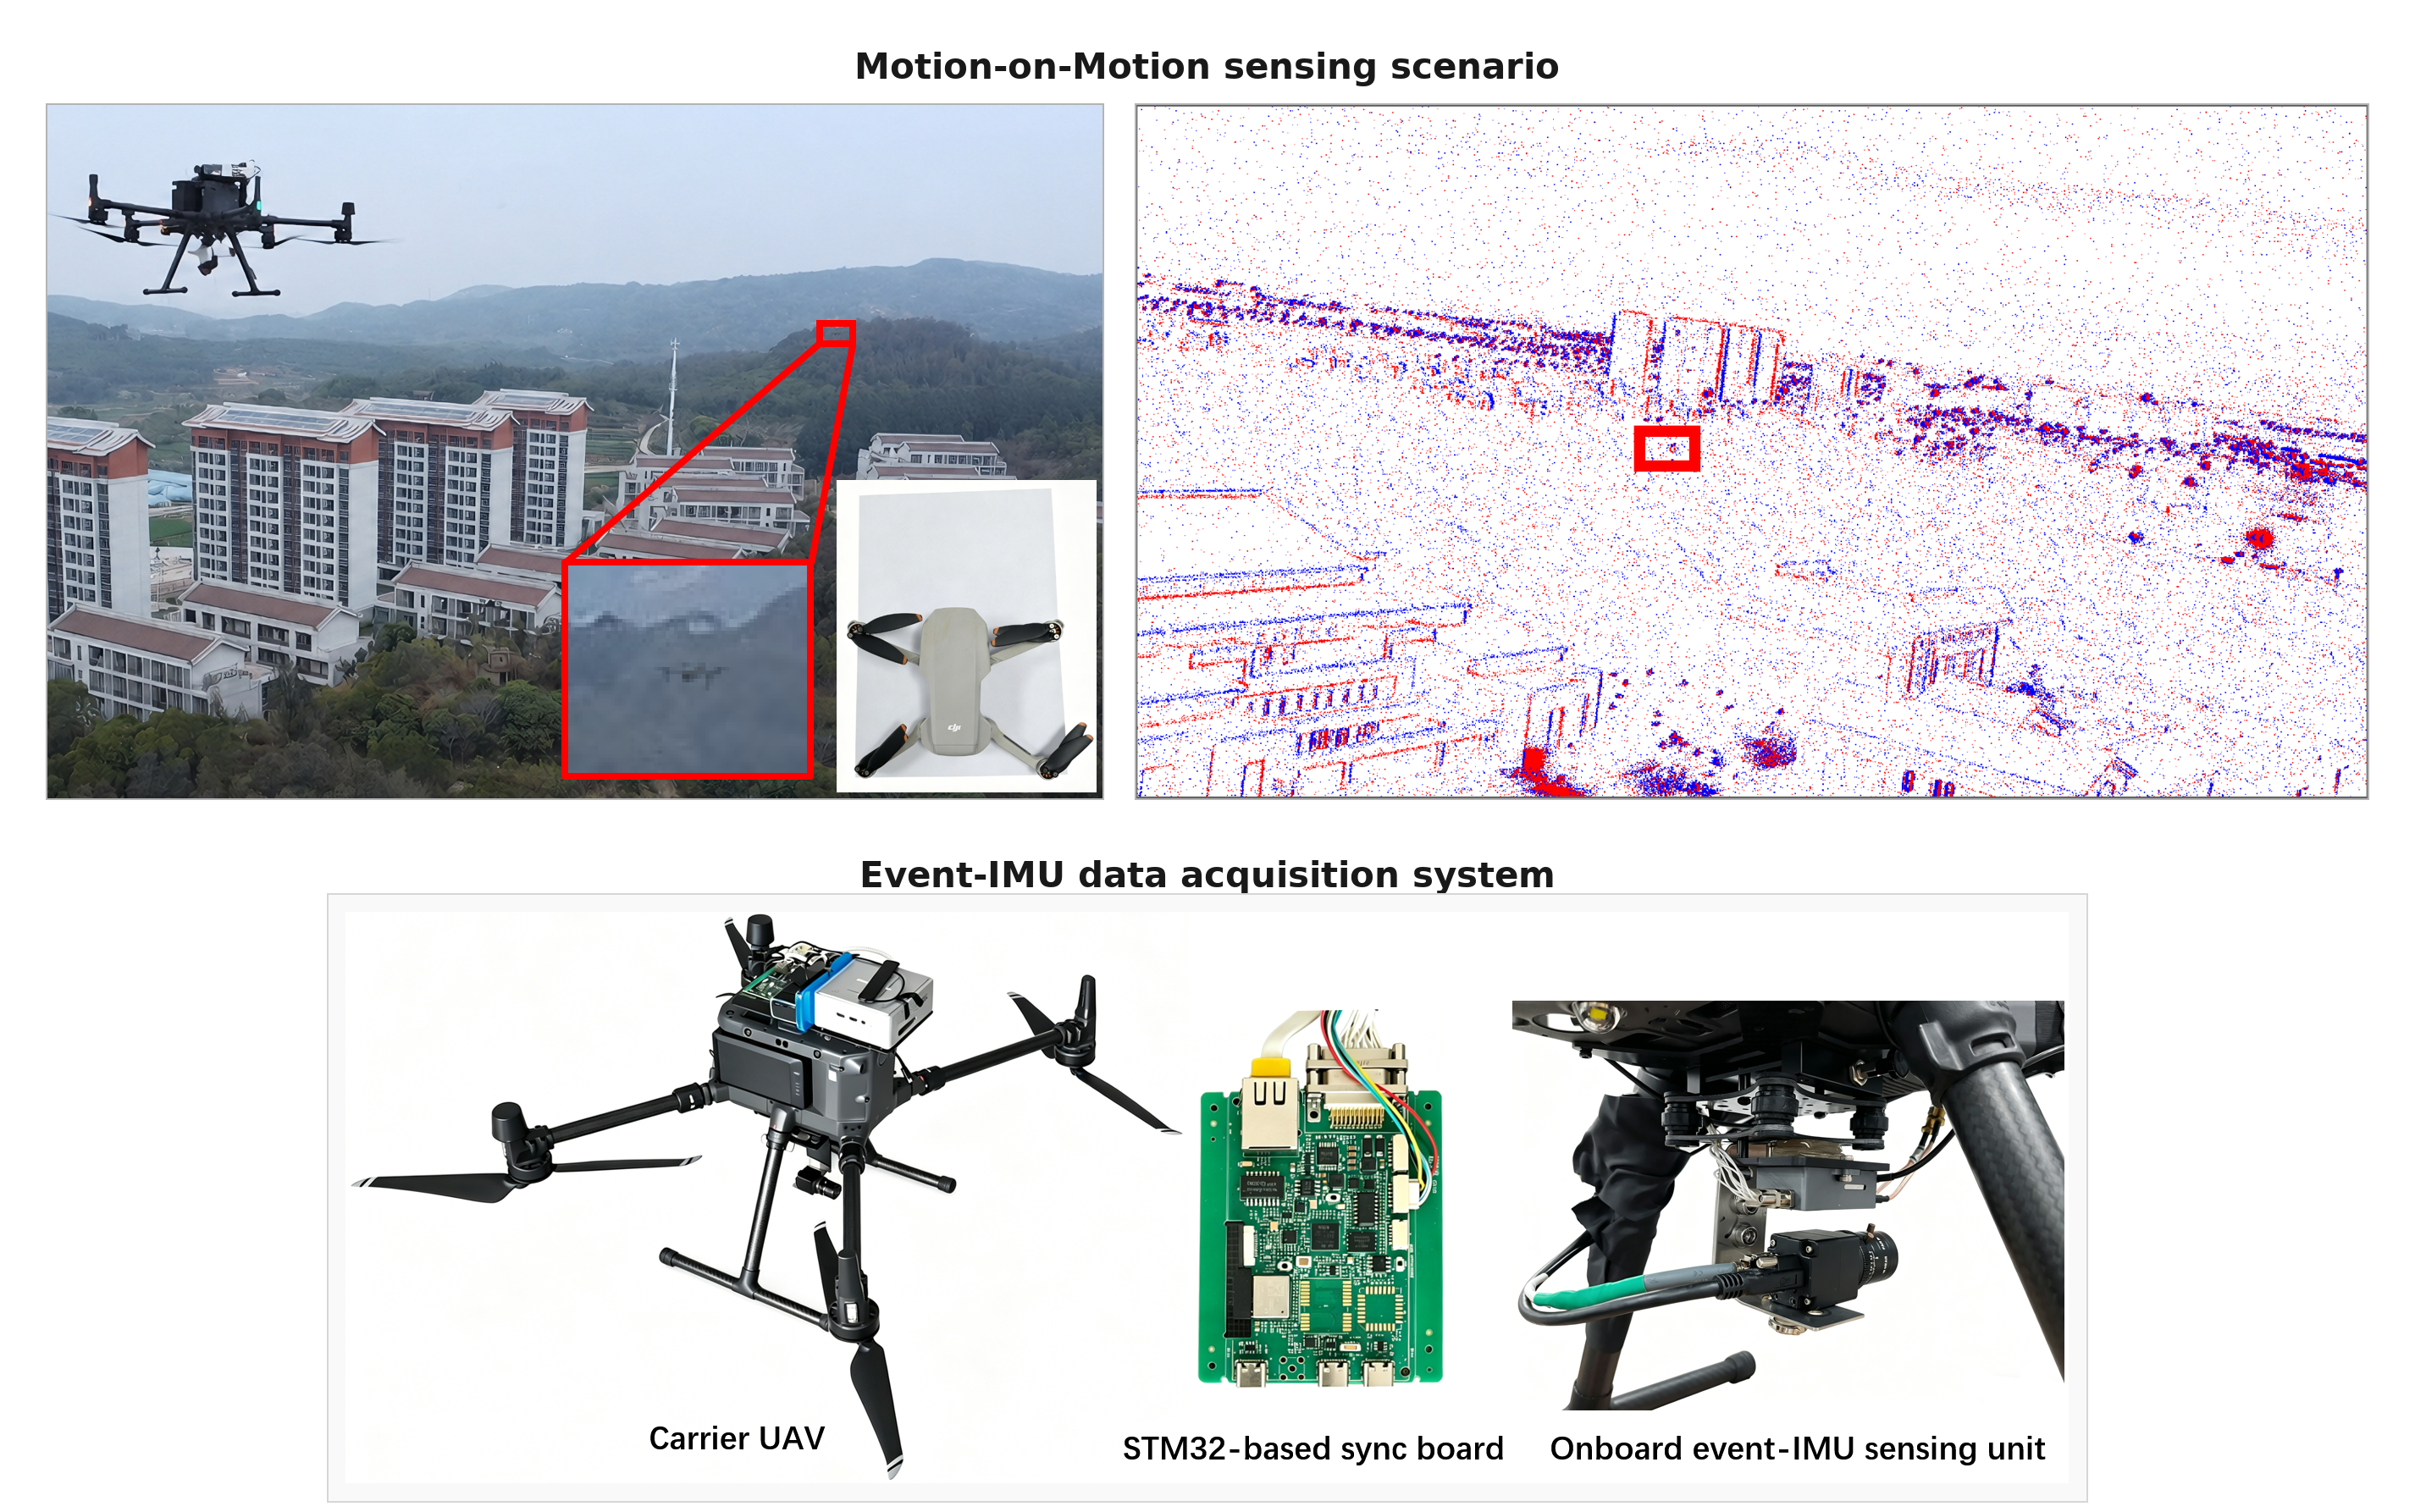
M²E-UAV: A Benchmark and Analysis for Onboard Motion-on-Motion Event-Based Tiny UAV Detection
简介:本文面向机载事件相机下观测平台与目标同时运动的“动对动”(Motion-on-Motion)微小无人机检测场景,构建了首个针对该问题的事件相机数据集与评测基准 M²E-UAV。数据集同步提供高分辨率事件流与 IMU 惯性信息,覆盖不同光照和复杂背景场景,并通过时序传播构建细粒度的事件级目标标注。在此基础上,本文对事件帧、事件张量和事件点集等不同表示及多类代表性检测方法进行了系统实验,并进一步分析 IMU 信息在机载自运动条件下的作用。实验结果系统揭示了机载自运动背景下微小无人机检测的关键影响因素,并验证了不同事件表示及 IMU 信息在该场景中的作用,为后续机载事件感知及事件—惯性协同研究提供了新的数据基础与评测平台。
该论文第一作者是博士生严伟奇、硕士生陈利鑫,通讯作者是臧彧副教授、蔡志鹏研究员(Meta AI)。并由侯翔瑞、汪有标、施阳阳研究员(Meta AI)、王程教授共同合作完成。
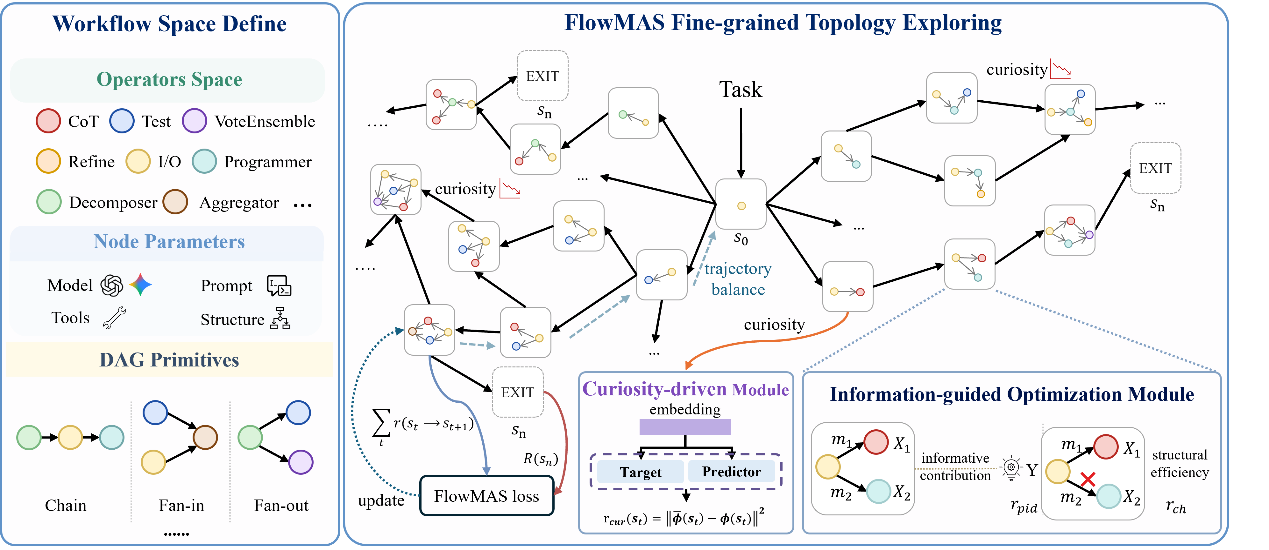
FlowMAS: Learning Multi-Agent Workflow Topology via Information-guided Generative Flow Network
简介:针对大语言模型智能体工作流在复杂离散拓扑空间中难以高效探索与优化的难题,本文提出基于生成流网络的工作流拓扑构建框架 FlowMAS。该框架包含三个核心部分:1)以生成流网络为拓扑生成骨干,自动探索适配任务需求的多样化高质量工作流;2)结构感知的好奇心驱动模块鼓励探索新颖的拓扑结构,缓解探索局限于少数结构模式问题;3)信息引导优化模块则综合衡量不同智能体的信息贡献与通信效率,以促进信息量更丰富、协作更有效的交互模式。实验表明,FlowMAS 在生成高质量的工作流拓扑方面优于基线方法,且兼具任务适应性、资源效率与跨模型稳健性。
该论文第一作者是博士生王海涛、硕士生梁辰景,通讯作者是沈思淇长聘副教授。并由张海鹏、胡家威、王思诚、梅松竹副研究员(国防科技大学)、温程璐教授、王程教授共同合作完成。